Zaštitite podatke: RPO i RTO na primjeru 4 sata i 30 minuta
RPO označava koliko podataka tvrtka smije izgubiti, izraženo u vremenu od zadnje sigurne kopije. RTO označava koliko dugo sustav smije biti nedostupan prije nego šteta postane neprihvatljiva. Razlika je jednostavna: RPO gleda unatrag, prema izgubljenim podacima, a RTO gleda unaprijed, prema brzini oporavka. Oba cilja imaju smisla tek kad ih podupru analiza učinka na poslovanje i redovito testiranje.
Ukratko:
- Ako je RPO postavljen na jedan sat, tvrtka može izgubiti do sat vremena podataka, dok je za gubitak od deset minuta potrebna sigurnosna kopija svakih deset minuta.
- Za kritične sustave s RTO-om od nekoliko minuta do sat vremena preporučuje se replikacija u stvarnom vremenu i brzo aktiviranje pričuvnih okruženja, dok standardni sustavi mogu koristiti dnevne sigurnosne kopije.
- Testiranje planova oporavka trebalo bi se provoditi redovno, barem mjesečno ili tromjesečno, kako bi se provjerila njihova učinkovitost i spriječile neočekivane pogreške u kritičnim trenucima.
- Za velike incidente, poput oštećenja diskova ili pada RAID polja, preporučuje se angažiranje stručnih laboratorija za spašavanje podataka radi sigurnog oporavka i sprječavanja trajnog gubitka podataka.
Sadržaj
- Definicija RPO i RTO: što se zapravo mjeri
- Kako odrediti RTO i RPO za svoj sustav
- Preporučeni RTO i RPO po tipu sustava
- Kako RPO i RTO oblikuju arhitekturu backup-a
- Testiranje RTO i RPO: kako provjeriti da plan stvarno radi
- Kada je vrijeme za stručni laboratorij za spašavanje podataka
- Izvori
Definicija RPO i RTO: što se zapravo mjeri
RPO (ciljna točka oporavka) određuje maksimalno prihvatljivo razdoblje između zadnje sigurne kopije i trenutka incidenta. Ako je RPO postavljen na jedan sat, tvrtka prihvaća da će u najgorem slučaju izgubiti podatke unesene u tom vremenskom prozoru. RTO (ciljno vrijeme oporavka) mjeri nešto drugo, koliko dugo sustav smije stajati prije nego se vrati u pogon.
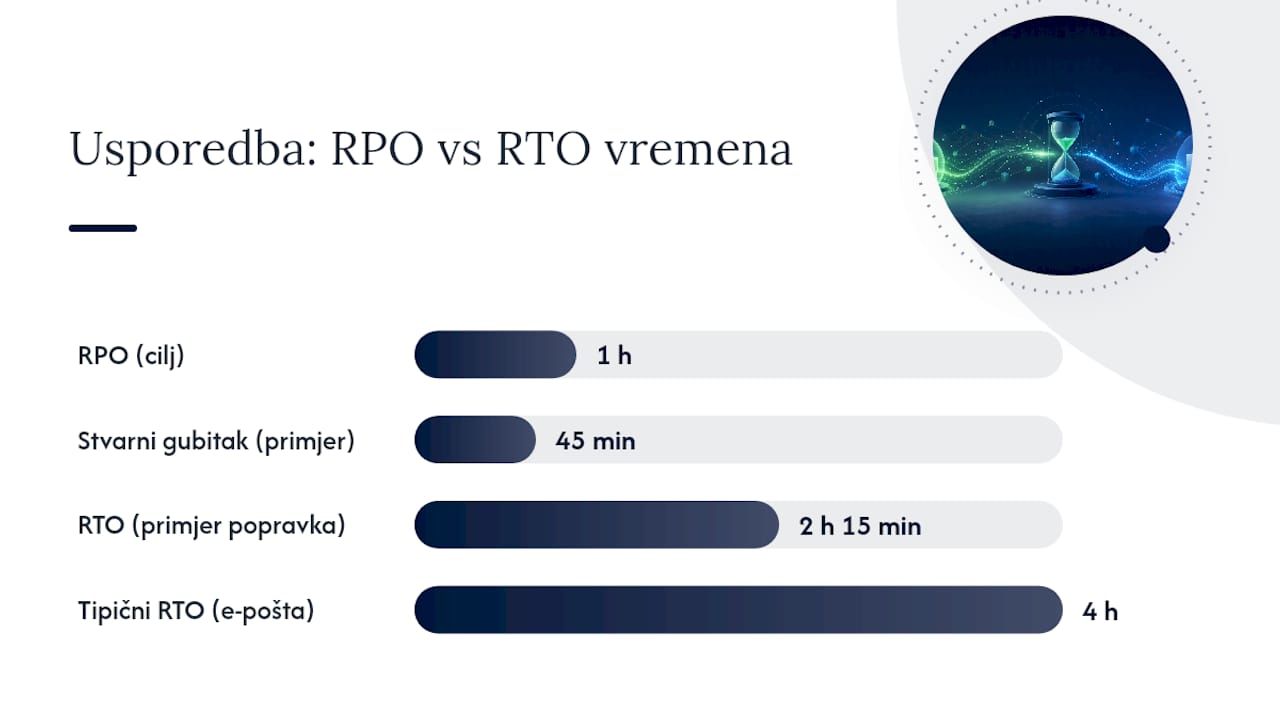
Razliku je najlakše zamisliti na vremenskoj crti. Zadnja sigurnosna kopija napravljena je u 8 sati ujutro. Kvar se dogodi u 8:45. Razdoblje između te dvije točke, 45 minuta, jest stvarni gubitak podataka koji se mjeri kroz RPO. Nakon kvara počinje popravak, a vrijeme potrebno da sustav opet proradi, recimo do 11 sati, predstavlja RTO. Prema izvoru Cyber, tipičan primjer za sustav e‑pošte je RTO od četiri sata, dok baza podataka s naplatnim transakcijama često zahtijeva RPO od svega sat vremena, jer svaka izgubljena transakcija znači stvaran financijski trošak.
Praktičnu razliku najbolje pokazuju dva svakodnevna primjera:
- Sustav e‑pošte može podnijeti duži prekid rada (veći RTO), jer poruke uglavnom stižu ponovno ili se mogu poslati kasnije.
- Sustav online naplate ne podnosi gubitak ni deset minuta transakcija (nizak RPO), jer se ti podaci ne mogu rekonstruirati naknadno.
Ta dva primjera pokazuju zašto univerzalni cilj za cijelu infrastrukturu rijetko funkcionira. Cyber.hr ističe da RPO i RTO treba definirati zasebno za svaku radnu okolinu, a ne primjenjivati jedinstvenu vrijednost na sve poslovne procese.
Kako odrediti RTO i RPO za svoj sustav
Određivanje ovih ciljeva nije proizvoljna procjena, nego rezultat konkretne analize. Postupak koji donosi upotrebljive brojke izgleda ovako:
- Provedite analizu učinka na poslovanje (BIA). Popišite sve kritične sustave i procese, od baze klijenata do interne mreže, i za svaki procijenite koliko brzo prekid rada šteti poslovanju.
- Izračunajte financijski gubitak po satu prekida. Ako sat nedostupnosti web trgovine uzrokuje znatan financijski gubitak zbog izgubljene prodaje, taj trošak utječe na to koliko RTO smije biti dugačak prije nego postane nepovoljan.
- Odredite prihvatljivi gubitak podataka. Postavite pitanje koliko podataka tvrtka realno može ponovno unijeti ili rekonstruirati bez posljedica, a koliko ne. Odgovor postaje RPO.
- Uskladite raspored sigurnosnih kopija s RPO vrijednošću. Prema Serverionu, RPO od sat vremena zahtijeva backup barem svakih sat vremena, ili kontinuiranu replikaciju uz mogućnost oporavka na točno određeni trenutak (PITR).
- Prioritizirajte sustave prema kritičnosti. Ne troše se jednaka sredstva na arhivu starih dokumenata i na sustav koji obrađuje plaćanja u stvarnom vremenu.
Konkretan primjer: ako prekid rada ERP sustava košta 500 eura po satu, a tvrtka procijeni da može podnijeti najviše četiri sata zastoja prije nego gubitak postane neprihvatljiv, RTO se postavlja na četiri sata. Ako se pritom prihvaća gubitak podataka od najviše 30 minuta unosa, RPO iznosi 30 minuta, što diktira učestalost sigurnosnog kopiranja.
Preporučeni RTO i RPO po tipu sustava
Vrijednosti se razlikuju ovisno o tome koliko je sustav osjetljiv na prekid i gubitak podataka. Prema Raptoricu, tipična podjela prema razini kritičnosti izgleda ovako:
| Razina kritičnosti | Primjer sustava | Preporučeni RTO | Preporučeni RPO |
|---|---|---|---|
| Kritično | transakcijski i naplatni sustavi | minute do 1 sat | gotovo nula |
| Važno | ERP, CRM | nekoliko sati | do 1 sat |
| Standardno | interni alati, intranet | 1 do 2 dana | do 4 sata |
| Arhiva | dugoročna pohrana dokumenata | nekoliko dana | do nekoliko dana |
Kritični sustavi zahtijevaju najskuplju arhitekturu, često replikaciju u stvarnom vremenu i automatizirano prebacivanje na pričuvni sustav. Važni sustavi obično koriste kombinaciju redovitih sigurnosnih kopija i replikacije s manjim odgodama. Standardni sustavi mogu se osloniti na klasičan dnevni backup, dok arhivski podaci trebaju prvenstveno pouzdanu, ali ne nužno brzu, pohranu. Razlika u trošku između tih razina zna biti nekoliko puta veća, pa svaki sustav vrijedi svrstati u pravu kategoriju umjesto primjene istog standarda na sve.
Kako RPO i RTO oblikuju arhitekturu backup-a
Postavljeni ciljevi izravno određuju tehnička rješenja koja tvrtka mora nabaviti ili izgraditi. To nije apstraktna odluka, nego niz konkretnih koraka koji proizlaze iz brojki utvrđenih u BIA analizi.
- Nizak RPO zahtijeva učestale sigurnosne kopije, snapshot mehanizme na razini minuta ili kontinuiranu replikaciju podataka između lokacija.
- Kratak RTO obično znači ulaganje u hot standby ili warm standby okruženje, gdje se pričuvni sustav može aktivirati automatski ili uz minimalnu ljudsku intervenciju.
- Dulji RTO dopušta jeftinija cold standby rješenja, gdje se sustav podiže iz sigurnosne kopije tek nakon incidenta, uz svjestan pristanak na duži prekid.
- Prema Serverionu, kraći RTO i RPO gotovo uvijek znače veći trošak, jer zahtijevaju infrastrukturu s visokom dostupnošću i mogućnošću brzog preusmjeravanja prometa.
- Operativno je nužno pratiti stopu uspješnosti vraćanja podataka i prosječno vrijeme popravka (MTTR), jer ti pokazatelji otkrivaju hoće li plan uopće funkcionirati kad zatreba.
Vrijedi razlikovati backup od arhiviranja, jer se ta dva pojma često miješaju, a imaju različitu ulogu u postizanju RPO cilja, kako objašnjava i analiza razlike između backup-a i arhiviranja.
Testiranje RTO i RPO: kako provjeriti da plan stvarno radi
Postavljeni ciljevi vrijede samo onoliko koliko su potvrđeni stvarnim testom. Bez provjere, RTO i RPO ostaju brojke na papiru koje se raspadnu čim se pojavi pravi kvar.
- Odaberite scenarij. Simulirajte kvar diska, gubitak baze podataka ili potpuni pad poslužitelja, ovisno o tome koji sustav testirate.
- Izvedite oporavak prema pisanom postupku (runbooku). Postupak mora biti dokumentiran korak po korak, a ne prepušten improvizaciji osobe koja ga izvodi.
- Izmjerite stvarno vrijeme oporavka i stvarni gubitak podataka. Usporedite dobivene brojke s ciljanim RTO i RPO vrijednostima.
- Zabilježite rezultat i odstupanja. Svaki test treba završiti zapisnikom koji navodi je li cilj ispunjen i što je uzrokovalo eventualno kašnjenje.
Postoje tri osnovna tipa testova: obnova iz sigurnosne kopije (restore test), prebacivanje na pričuvni sustav (failover test) i simulacija za stolom (tabletop vježba) gdje tim prolazi kroz scenarij bez stvarnog gašenja sustava. Prema Youstableu, kritične sustave vrijedi testirati mjesečno ili tromjesečno, ovisno o tome koliko je poslovanje osjetljivo na njihov prekid. Nepostojanje testiranih i dokumentiranih postupaka predstavlja jedan od najčešćih razloga zašto plan oporavka ne funkcionira kada zaista zatreba. Dodatnu metodologiju provjere backup sustava opisuje i Symmetry Network Management.
Profesionalni savjet: Postavite automatsku provjeru integriteta sigurnosnih kopija odmah nakon svake veće promjene infrastrukture, na primjer nakon migracije baze podataka ili nadogradnje poslužitelja. Upravo u tim trenucima najčešće puca lanac koji povezuje RPO cilj sa stvarnim stanjem sustava.
Kada je vrijeme za stručni laboratorij za spašavanje podataka
Dobro postavljen RPO i RTO ne štite od svakog scenarija. Fizičko oštećenje diska, pad RAID polja ili kvar SSD kontrolera često nadilaze mogućnosti internog IT tima, koliko god plan oporavka bio dobro napisan. U takvim trenucima testirani runbook kaže da je vrijeme za poziv van organizacije, a ne za dodatne pokušaje popravka koji mogu trajno uništiti podatke.
Stručni laboratorij za spašavanje podataka (InfoLAB) s dugogodišnjim iskustvom i potvrdom ISO 9001:2015. Rad u posebnim kontroliranim prostorima omogućuje sigurno otvaranje hard diskova i SSD uređaja bez dodatnog oštećenja podatkovnih ploča, što kućni pokušaji popravka gotovo nikad ne mogu ponoviti. Kad se RAID polje raspadne, mobilni uređaj prestane raditi nakon pada, ili poslovna baza podataka postane nečitljiva, poziv laboratoriju umjesto daljnjeg eksperimentiranja često je razlika između potpunog oporavka i trajnog gubitka. Pregledajte uslugu spašavanja podataka s hard diskova, SSD‑ova, RAID i NAS sustava ili zatražite hitnu dijagnostiku putem kontakt stranice u Zagrebu prije nego pokušate bilo kakav samostalni popravak.
Izvori
- Plan oporavka nakon incidenta | Disaster Recovery
- Kontinuitet poslovanja i oporavak (BCP i DR)
- Cloud DR Metrics: RTO i RPO objašnjeni