VMFS oporavak podataka: što učiniti kad datastore nestane
Kada ESXi host prestane vidjeti datastore, kada se nakon nestanka struje volumen prikaže kao prazan ili kada virtualni strojevi odjednom ne žele krenuti, podaci najčešće još postoje na diskovima. Ono što je oštećeno ili izgubljeno obično su VMFS metapodaci, odnosno “karta” koja govori gdje se nalaze blokovi svake VMDK datoteke. Oporavak je u tom trenutku često moguć, ali samo ako se na volumen više ništa ne zapisuje. Svaka naknadna operacija, od ponovnog formatiranja do pokušaja “popravka”, može tu kartu trajno prebrisati. U nastavku objašnjavamo kako VMFS čuva podatke, koji su uzroci kvara najčešći, što smijete napraviti u prvih pola sata i kada je vrijeme da se obratite laboratoriju za spašavanje podataka.
TL;DR
- Ako datastore nestane ili je prazan, odmah zaustavite sve zapise na taj LUN i ne kreirajte novi datastore na istom prostoru.
- Brisanje datastorea u vSphereu je destruktivna i nepovratna operacija, a novi volumen na istom LUN-u fizički prepisuje stare podatke.
- Blokovi VMDK datoteke raspoređeni su po cijelom volumenu i mogu se pronaći samo preko VMFS metapodataka, pa su metapodaci ključ oporavka.
- Snapshot nije backup: oštećen .vmsd opisnik ili pun datastore mogu onesposobiti cijeli virtualni stroj.
- Laboratorij najprije radi fizičku sliku (image) svakog diska, rekonstruira RAID, a tek zatim VMFS strukturu i VMDK datoteke, sve na kopiji, nikad na originalu.
Sadržaj
- Kako VMFS čuva virtualne strojeve
- Najčešći uzroci gubitka VMFS datastorea
- Prvih 30 minuta: što učiniti, a što nikako
- Kada je oporavak još moguć, a kada nije
- Snapshot nije backup
- Kako laboratorij pristupa VMFS oporavku
- Spašavanje VMFS datastorea u našem laboratoriju
- Što pripremiti prije poziva laboratoriju
- Kako smanjiti rizik od gubitka VMFS podataka
- Česta pitanja
- Izvori
Kako VMFS čuva virtualne strojeve
VMware opisuje VMFS kao klasterski datotečni sustav visokih performansi koji omogućuje da više ESXi hostova istovremeno pristupa istoj zajedničkoj pohrani. Upravo ta osobina čini ga praktičnim u produkciji, ali i osjetljivim kod kvara: na istom volumenu istovremeno rade zaključavanja (locks), heartbeat zapisi i metapodaci više hostova.

Za oporavak je najvažnije razumjeti jednu činjenicu. Prema Broadcomovoj bazi znanja, podaci svake datoteke na VMFS datastoreu raspoređeni su po cijelom volumenu, a blokovi koji čine datoteku mogu se identificirati samo iz VMFS metapodataka. Drugim riječima, VMDK od 500 GB nije jedan neprekinuti komad na disku. To je niz blokova razbacanih po LUN-u, a redoslijed tih blokova zapisan je u metapodacima.
U praksi to znači sljedeće:
- Ako su metapodaci netaknuti, a problem je u putanjama, montiranju ili prepoznavanju volumena, podaci su obično u potpunosti dostupni.
- Ako su metapodaci djelomično oštećeni, specijalizirani laboratorij ih često može rekonstruirati iz preostalih struktura.
- Ako su metapodaci prebrisani, rekonstrukcija postaje znatno teža, a ishod ovisi o tome koliko je novih podataka zapisano preko starih.
Ispod VMFS-a gotovo uvijek se nalazi još jedan sloj: RAID polje na serveru, SAN ili NAS uređaj koji LUN predstavlja hostu. Kvar na tom sloju (ispali disk, degradirano polje, neuspjela rekonstrukcija) za ESXi izgleda kao oštećen datastore, iako je uzrok zapravo hardverski. Više o tome kako se slojevi pohrane slažu jedan na drugi pronaći ćete u našem vodiču o obnovi RAID metapodataka.
Najčešći uzroci gubitka VMFS datastorea
Simptom koji vidite u vSphere klijentu rijetko otkriva pravi uzrok. Isti prikaz “inactive” ili prazan datastore može nastati iz potpuno različitih razloga, a o uzroku ovisi i što je sigurno napraviti.
| Uzrok | Tipičan simptom | Što to znači za podatke |
|---|---|---|
| Kvar diska ili RAID polja ispod LUN-a | Datastore nedostupan, I/O greške, spori odziv | Podaci su fizički na diskovima, ali polje treba rekonstruirati prije VMFS-a |
| Oštećenje metapodataka nakon nadogradnje ili održavanja | Dijeljeni datastore postaje nedostupan na jednom ili više hostova | Blokovi su obično na mjestu, oštećena je struktura koja ih povezuje |
| Nestanak struje ili nekontrolirano gašenje | Datastore prikazan kao prazan, nema mapa ni VM-ova | Često oštećeno zaglavlje ili metapodaci, podaci uglavnom ostaju |
| Slučajno brisanje VM-a ili VMDK-a | Nedostaje pojedini stroj ili disk | Ovisi o tome koliko je prostora nakon toga ponovno iskorišteno |
| Brisanje datastorea i kreiranje novog | Novi, prazan volumen na istom LUN-u | Najteži slučaj, oporavak je često nemoguć |
| Ransomware napad na ESXi | Kriptirane VMDK datoteke, poruka otkupnine | Ovisi o načinu kriptiranja i postojanju neoštećenih kopija |
| Problemi sa snapshotovima | VM ne kreće, greške u lancu delta diskova | Osnovni disk je često čitljiv, gube se promjene iz snapshota |
Broadcom posebno navodi scenarij u kojem dijeljeni VMFS datastore tijekom nadogradnje ili održavanja postane nedostupan uz prijavljenu korupciju metapodataka. To je čest slučaj u okruženjima s više hostova i zajedničkim SAN-om, gdje se promjena na jednom hostu odrazi na sve ostale.
Kod napada kriptiranjem situacija je drugačija jer je uzrok namjeran, a ne tehnički kvar. O tome kako postupiti u takvom slučaju pisali smo u vodiču oporavak podataka nakon ransomware napada.
Prvih 30 minuta: što učiniti, a što nikako
Najviše VMFS oporavaka ne propadne zbog samog kvara, nego zbog onoga što se dogodi neposredno nakon njega. Pod pritiskom da se produkcija vrati u rad, administratori pokušavaju ponovno montirati volumen, mijenjati potpis ili pokretati popravke. Svaki od tih koraka zapisuje na disk.
Što napraviti odmah
- Zaustavite zapisivanje na pogođeni LUN. Ugasite ili premjestite virtualne strojeve koji još rade s tog datastorea, ako je to moguće bez dodatnih zapisa, i obustavite zakazane backup poslove koji ciljaju isti volumen.
- Ne dirajte konfiguraciju pohrane. Ne pokrećite rekonstrukciju RAID polja, ne mijenjajte redoslijed diskova i ne inicijalizirajte polje na kontroleru.
- Zabilježite stanje. Fotografirajte ili kopirajte poruke grešaka, stanje RAID kontrolera, redoslijed diskova u ležištima i verziju ESXi-ja. Ti podaci laboratoriju štede vrijeme.
- Sačuvajte logove. Logovi hosta pokazuju što se događalo prije kvara. Francuska agencija za kibernetičku sigurnost ANSSI u svojim smjernicama za sigurnost VMware infrastrukture naglašava važnost centraliziranog prikupljanja i nadzora logova, jer se iz njih može rekonstruirati tijek incidenta.
- Utvrdite gdje je problem. Razlikujte nedostupnost zbog putanja ili mreže prema SAN-u od stvarnog oštećenja volumena. Ako drugi host vidi datastore normalno, problem vjerojatno nije u podacima.
Što nikako ne raditi
- Ne brišite datastore i ne kreirajte novi na istom LUN-u. Broadcom izričito navodi da je brisanje datastorea destruktivna i nepovratna operacija koja uništava VMFS metapodatke i particijsku tablicu, a novi volumen preko starog fizički prepisuje izvorne blokove.
- Ne pokrećite resignature ni popravak volumena naslijepo. Ove operacije mijenjaju metapodatke. Na zdravom volumenu služe svojoj svrsi, ali na oštećenom mogu prebrisati upravo strukture koje su potrebne za rekonstrukciju.
- Ne brišite particije da bi host “ponovno vidio” disk. Neki online vodiči to predlažu kao rješenje za nevidljive diskove, ali na disku s podacima to je izravan put do gubitka.
- Ne vraćajte backup na isti LUN dok niste sigurni da Vam podaci s njega više ne trebaju.
Ako na oštećenom datastoreu postoje podaci kojih nema nigdje drugdje, najsigurniji korak je ne raditi ništa dok se ne napravi fizička slika diskova. Kontrolnu listu za IT odjele pripremili smo u laboratorijskom vodiču za oporavak VMware datastorea.
Kada je oporavak još moguć, a kada nije
Ne postoji univerzalan postotak uspjeha za VMFS oporavak, jer ishod ovisi o tri stvari: stanju fizičkih diskova, stanju metapodataka i količini podataka zapisanih nakon incidenta.
Dobre šanse postoje kada:
- je datastore nedostupan, ali na njega nitko nije zapisivao;
- je ispao jedan ili više diskova iz RAID polja, a polje nije ponovno inicijalizirano;
- je nakon nestanka struje volumen prikazan kao prazan, ali nije formatiran;
- je obrisan pojedini VM, a datastore je nakon toga malo korišten.
Šanse su smanjene kada:
- je nakon kvara pokrenuta rekonstrukcija RAID polja s pogrešnim redoslijedom diskova;
- su nakon incidenta na isti volumen nastavili raditi drugi virtualni strojevi;
- su metapodaci djelomično prebrisani nekim pokušajem popravka.
Oporavak je najčešće nemoguć kada je datastore obrisan, na istom LUN-u kreiran novi volumen i na njega zapisani novi podaci. Broadcom za situacije s prebrisanim metapodacima navodi da specijalizirani pružatelji usluga oporavka podataka možda mogu rekonstruirati prebrisane strukture, ali bez jamstva. Zato je brzina reakcije važnija od bilo čega drugog: što ranije prestane zapisivanje, to više podataka ostaje netaknuto.
Poseban slučaj su SSD diskovi i all-flash polja. Kod njih naredbe za oslobađanje prostora (TRIM, UNMAP) mogu uzrokovati da kontroler fizički obriše blokove koji su označeni kao slobodni. Razlike u oporavku s flash i magnetskih medija detaljnije objašnjavamo u vodiču razlike SSD i HDD oporavka podataka.
Snapshot nije backup
Mnogi IT odjeli snapshotove koriste kao brzu zaštitu prije nadogradnje ili promjene konfiguracije. To je korisno, ali nije zamjena za sigurnosnu kopiju. Broadcom u pregledu snapshotova u vSphereu jasno navodi da se snapshotovi ne smiju smatrati backupom virtualnih diskova te da dugotrajan rad virtualnog stroja na snapshotu utječe na performanse.
Razlog je u načinu rada. Snapshot ne kopira disk, nego od trenutka nastanka sve promjene zapisuje u zasebnu delta datoteku. Osnovni disk i lanac delta datoteka ovise jedan o drugome, a sve se nalazi na istom datastoreu. Ako se datastore ošteti, nestaju i originali i snapshotovi.

Dodatnu točku kvara predstavlja opisna datoteka. Prema Broadcomu, datoteka .vmsd čuva metapodatke snapshotova i hijerarhiju među njima. Kada se ona ošteti ili kada se datastore napuni jer snapshotovi rastu bez nadzora, virtualni stroj može prestati raditi.
Rješenje je backup na odvojenoj pohrani. Dell u svojim preporukama za vSphere okruženja navodi da su snapshotovi na razini diskovnog polja učinkovit način zaštite podataka virtualnih strojeva i postavljanja RPO-a, no i oni žive na istom polju, pa se uz njih preporučuje i kopija izvan primarne pohrane. Kada zakaže i sam backup medij, pogledajte naš tekst kada zvati laboratorij za oporavak s backup traka.
Kako laboratorij pristupa VMFS oporavku
Profesionalni oporavak VMFS datastorea radi se odozdo prema gore, sloj po sloj, i uvijek na kopijama, nikad na originalnim diskovima.
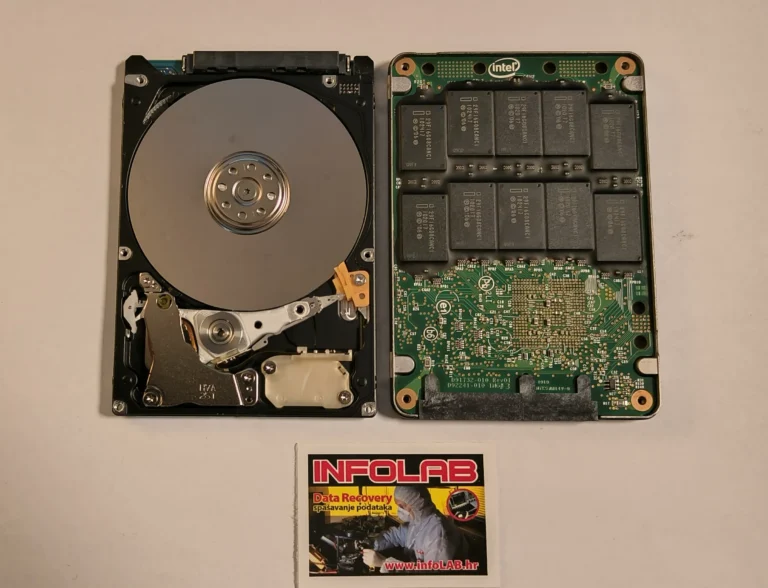
- Dijagnostika fizičkih diskova. Svaki disk iz servera ili SAN-a pregledava se zasebno. Kod magnetskih diskova provjeravaju se glave za čitanje, motor i stanje podatkovnih ploča, a kod SSD-ova kontroler i flash memorija. Disk s mehaničkim oštećenjem otvara se isključivo u čistoj komori.
- Izrada fizičke slike (image) svakog diska. Prije bilo kakve analize svaki disk kopira se sektor po sektor. Oštećena područja čitaju se više puta i s prilagođenim parametrima, a originalni diskovi nakon toga ostaju netaknuti.
- Rekonstrukcija RAID polja. Iz slika diskova utvrđuju se razina polja, veličina bloka (stripe), redoslijed diskova i paritet. Tek kada je polje virtualno sastavljeno, dobiva se slika LUN-a onakva kakvu je ESXi vidio.
- Analiza VMFS strukture. Na slici LUN-a traže se zaglavlje volumena, metapodaci i tablice koje povezuju datoteke s blokovima. Oštećeni dijelovi rekonstruiraju se iz preostalih, sačuvanih struktura.
- Izdvajanje VMDK datoteka i konfiguracije. Virtualni diskovi, konfiguracijske datoteke i, gdje je moguće, lanci snapshotova izdvajaju se kao cjelina.
- Provjera unutar virtualnog stroja. Oporavljeni VMDK sam po sebi nije dovoljan. Provjerava se datotečni sustav gosta (NTFS, ext4, LVM) te ključne baze i aplikacijski podaci. Ako gost koristi LVM, dodatno se rekonstruira i taj sloj, o čemu više u tekstu kako funkcionira LVM particija.
- Predaja podataka. Podaci se predaju na novom mediju ili se, uz dogovor, priprema okruženje iz kojeg se virtualni strojevi mogu ponovno pokrenuti.
Takav pristup traje dulje od “brzog popravka” na produkcijskom hostu, ali je jedini koji ne riskira ono što je još ostalo na diskovima.
Spašavanje VMFS datastorea u našem laboratoriju
Datarecovery, laboratorij poznat i pod imenom InfoLAB, bavi se spašavanjem podataka od 1993. godine i jedini je laboratorij za spašavanje podataka u regiji s certifikatom ISO 9001:2015. Radimo s hard diskovima, SSD-ovima, RAID poljima i NAS uređajima, a diskove s mehaničkim oštećenjima otvaramo u čistim komorama klase CLASS 100/10. Vrijedi naše pravilo “no Data, no Money”: ako podatke ne oporavimo, ne plaćate oporavak. Za tvrtke kojima stoji produkcija dogovaramo i hitnu intervenciju.
Ako je Vaš VMFS datastore nedostupan, a na njemu su podaci kojih nemate drugdje, obratite nam se prije bilo kakvog pokušaja popravka. Detalje o usluzi pronaći ćete na stranici spašavanje podataka s RAID polja i NAS uređaja, a više o radu s poljima u tekstu RAID spašavanje podataka.
Što pripremiti prije poziva laboratoriju
Što više informacija dostavite uz diskove, to brže možemo postaviti dijagnozu. Prije kontakta pripremite:
- Model servera ili diskovnog polja i model RAID kontrolera.
- Razinu RAID polja (RAID 5, 6, 10 i slično) i broj diskova, ako ih znate.
- Redoslijed diskova u ležištima. Označite svaki disk prije vađenja, primjerice naljepnicom s brojem ležišta.
- Verziju ESXi-ja i VMFS-a (VMFS 5 ili VMFS 6).
- Opis događaja: što se dogodilo prije kvara (nadogradnja, nestanak struje, zamjena diska) i koje su radnje poduzete nakon toga.
- Popis prioriteta: koji su virtualni strojevi i podaci najvažniji. Kod velikih volumena to omogućuje da se ključni podaci izdvoje prvi.
- Podatke o enkripciji, ako su virtualni strojevi ili diskovi kriptirani, te ključeve ili pristupne podatke.
Ne šaljite samo onaj disk koji je “ispao”. Za rekonstrukciju polja potrebni su svi diskovi, uključujući i one koji se čine ispravnima. Opće korake za hitne situacije opisali smo u vodiču hitni koraci za oporavak podataka u Hrvatskoj.
Kako smanjiti rizik od gubitka VMFS podataka
Najjeftiniji oporavak je onaj koji nikad nije potreban. Nekoliko mjera znatno smanjuje vjerojatnost da će Vam laboratorij uopće zatrebati:
- Backup izvan primarnog datastorea. Kopija koja se nalazi na istom polju ili istom SAN-u ne štiti od kvara tog polja ni od kriptiranja.
- Redovita provjera povrata. Backup koji nikad nije testiran nije pouzdan. Barem povremeno vratite jedan virtualni stroj u izolirano okruženje.
- Nadzor snapshotova. Postavite upozorenja za snapshotove starije od nekoliko dana i za popunjenost datastorea.
- Nadzor diskova i RAID kontrolera. Upozorenja o degradiranom polju ili diskovima s rastućim brojem grešaka treba riješiti odmah, a ne pri sljedećem održavanju.
- Odvajanje upravljačke infrastrukture. ANSSI u već spomenutim smjernicama preporučuje da se infrastruktura virtualizacije promatra kao temelj neovisan o virtualnim strojevima koje pokreće, s odvojenim pristupom i administracijom.
- Kontrolirane nadogradnje. Prije nadogradnje ESXi-ja ili firmvera pohrane osigurajte svježi backup na drugoj lokaciji, a ne samo snapshot.
- Jasna procedura za incident. Zapišite tko smije odobriti brisanje ili ponovno kreiranje datastorea. Mnogi nepovratni gubici nastaju kada netko pod pritiskom napravi “čisti početak”.
Šire o organizaciji zaštite podataka u tvrtki pisali smo u tekstu sigurnost podataka u poslovnom okruženju.
Česta pitanja
Može li se oporaviti VMFS datastore koji se prikazuje kao prazan?
U većini slučajeva da, ako nakon toga nije kreiran novi volumen i ako se na LUN nije zapisivalo. Prazan prikaz često znači oštećeno zaglavlje ili metapodatke, dok su blokovi s podacima i dalje na diskovima. Odmah zaustavite zapise i ne pokušavajte ponovno formatirati volumen.
Je li moguće vratiti podatke nakon brisanja datastorea u vSphereu?
Brisanje datastorea uništava VMFS metapodatke i particijsku tablicu. Ako na istom LUN-u nije kreiran novi volumen niti zapisani novi podaci, laboratorij ponekad može rekonstruirati dio struktura. Ako je novi datastore već kreiran i korišten, oporavak je najčešće nemoguć.
Koliko traje VMFS oporavak podataka?
Trajanje ovisi o broju i kapacitetu diskova, stanju fizičkih medija i opsegu oštećenja metapodataka. Već sama izrada slika svih diskova velikog polja može trajati nekoliko dana. Za tvrtke kojima je produkcija zaustavljena dogovaramo hitnu intervenciju i prioritetno izdvajanje najvažnijih virtualnih strojeva.
Trebam li poslati sve diskove iz servera ili samo neispravan?
Pošaljite sve diskove iz polja, označene redoslijedom ležišta. Podaci virtualnog stroja raspoređeni su po svim diskovima, a bez kompletnog polja nije moguće rekonstruirati LUN ni VMFS volumen. Uz diskove priložite i podatke o RAID kontroleru i razini polja.
Što ako se snapshot oštetio, a osnovni disk je ispravan?
Osnovni VMDK je u tom slučaju često čitljiv, ali bez promjena nastalih nakon snapshota. Ovisno o stanju delta datoteka, laboratorij može pokušati spojiti lanac i vratiti i novije podatke. Ne brišite snapshot datoteke ručno dok se ne procijeni što se može spasiti.
Izvori
- VMware vSphere VMFS
- Can a VM or vmdk be recovered when VMFS metadata is overwritten? (Broadcom)
- Shared VMFS datastore becomes inaccessible, reported metadata corruption on the volume (Broadcom)
- Irrecoverable data loss after deleting a VMFS datastore and creating a new volume (Broadcom)
- ANSSI: Fondamentaux de sécurisation d’une infrastructure VMware
- Overview of virtual machine snapshots in vSphere (Broadcom)
- Troubleshooting virtual machine snapshot descriptor problems (Broadcom)
- Dell PowerStore: VMware vSphere Best Practices, snapshots and backup options